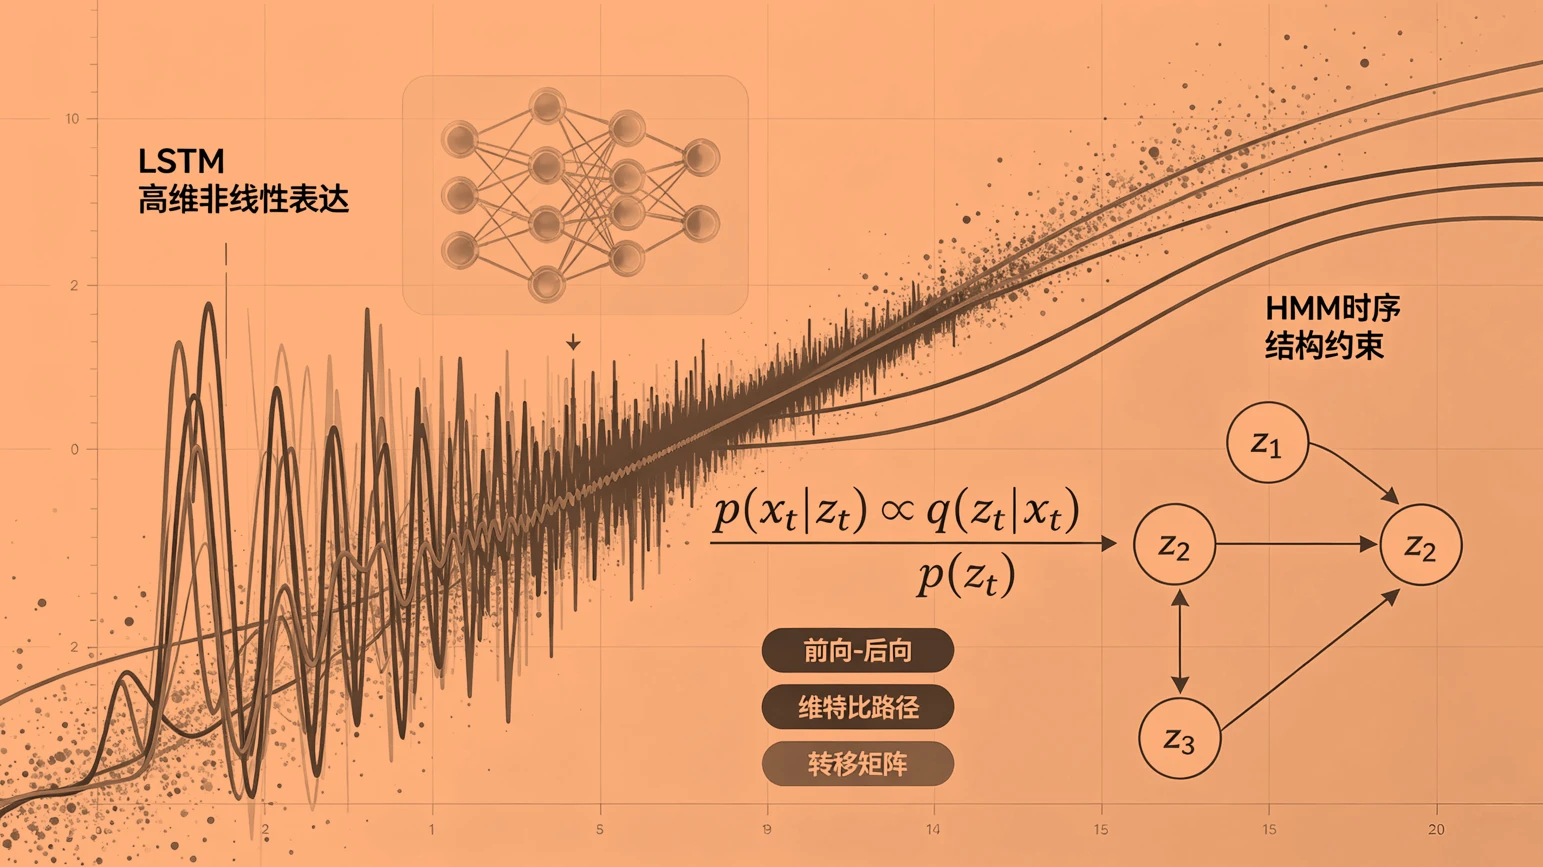
做时序建模的时候,我们其实一直在纠结一个事儿,既想要模型足够"聪明",能从原始数据里挖出复杂的非线性模式,又想要它足够"讲道理",有一套清晰、稳定、可解释的结构去约束它别瞎猜。
这两种诉求刚好对应两个经典模型:
- LSTM:擅长从数据里"炼"出高维、非线性、跨时间的规律,但它是个黑盒,容易在没有结构约束的空间里"飘",一遇到瞬时噪声就容易出问题;
- HMM(隐马尔可夫模型):靠离散状态 + 转移矩阵 + 概率推断来描述序列是怎么"生成"出来的,结构清晰、可解释,但对复杂观测的表达能力比较有限,抓不住太精细的非线性关系。
把这两个放一起用,其实不是什么新鲜事——早年做语音识别的 DNN-HMM / LSTM-HMM 就是这个思路,神经网络负责输出每一帧的状态后验,HMM 负责把这些后验按时序"捋顺",做最终解码。放到今天,这套框架一样适用于市场状态识别、传感器多变量时序、行为阶段划分之类的场景。
结合之后能拿到什么好处,大概是这几点:
- 结构正则化:HMM 的转移矩阵会对状态序列的平滑性和合法性加约束,防止神经网络对着瞬时噪声过拟合;
- 可解释性:HMM 的离散状态可以直接映射成人能看懂的东西,比如"语音子状态""市场风格""睡眠阶段";
- 可控解码:想要一条最优路径就上维特比(Viterbi),想要每个时刻的后验平滑结果就上前向-后向(forward-backward);
- 鲁棒性更好:真实世界的序列经常缺数据、有噪声、还不平稳,HMM 的转移结构相当于给模型上了个"锚",不会随便漂。
一、HMM 的作用
先假设我们有一串离散的隐状态序列 $z_1, z_2, \dots, z_T$,以及对应的观测序列 $x_1, x_2, \dots, x_T$,HMM 的定义其实就三块
- 初始分布:$\pi_i = p(z_1 = i)$
- 转移分布:$A_{ij} = p(z_t = j \mid z_{t-1} = i)$
- 发射分布:$b_i(x_t) = p(x_t \mid z_t = i)$
有了这三样,整个序列的联合分布就能写出来
$$ p(z_{1:T}, x_{1:T}) = \pi_{z_1} , b_{z_1}(x_1) \prod_{t=2}^{T} A_{z_{t-1} z_t} , b_{z_t}(x_t) $$
而我们真正关心的,通常是给定观测求似然 $p(x_{1:T})$,这个可以用前向算法在 $O(TK^2)$ 的时间里精确算出来($K$ 是状态数),前向变量定义为
$$ \alpha_t(i) = p(x_{1:t}, z_t = i) $$
递推关系是
$$ \alpha_t(i) = b_i(x_t) \sum_{j} \alpha_{t-1}(j) A_{ji} $$
对称地,后向变量
$$ \beta_t(i) = p(x_{t+1:T} \mid z_t = i) $$
递推
$$ \beta_t(i) = \sum_j A_{ij} , b_j(x_{t+1}) , \beta_{t+1}(j) $$
把前向和后向拼一起,就能算出每个时刻状态的后验(平滑结果)
$$ \gamma_t(i) = p(z_t = i \mid x_{1:T}) = \frac{\alpha_t(i),\beta_t(i)}{\sum_j \alpha_T(j)} $$
如果不要平滑后验、而是想要一条整体上最靠谱的状态路径,那就是维特比算法,用"最大值"代替"求和"来递推
$$ \delta_t(i) = b_i(x_t) \max_j \big[\delta_{t-1}(j) A_{ji}\big] $$
同时记录每一步的回溯指针,最后从末尾往回找出最优路径,这些递推工程上一般都放在对数域里做,不然概率连乘很快就下溢了。
二、LSTM 扮演的角色
LSTM 这边的逻辑就比较熟悉了,给定观测序列 $x_1, \dots, x_T$(每个是个向量),靠一套门控机制来维护跨时间步的记忆,
拿到隐藏状态 $h_t$ 之后,接一个线性层加 softmax,就能在每个时间步上输出一个离散状态的后验分布,
$$ q_\theta(z_t \mid x_{1:t}) = \text{softmax}(W h_t + b) $$
这里 $\theta$ 就是 LSTM 全部参数的集合。到这一步,LSTM 本质上是个逐帧的判别式分类器,它告诉你"这一时刻大概率处在哪个状态",但完全没考虑状态之间该怎么平滑过渡。
三、把两者连接起来
HMM 要的是发射似然 $p(x_t \mid z_t)$,可 LSTM 直接吐出来的是后验 $q(z_t \mid x_t)$,这俩不是一回事,得靠贝叶斯公式转一下,
$$ p(x_t \mid z_t) = \frac{p(z_t \mid x_t), p(x_t)}{p(z_t)} $$
由于 $p(x_t)$ 对所有状态都一样,解码时可以直接忽略这个常数项,于是常用的做法是
$$ p(x_t \mid z_t = i) ;\propto; \frac{q_\theta(z_t = i \mid x_t)}{p(z_t = i)} $$
其中先验 $p(z_t = i)$ 可以直接拿训练集里各状态出现的频率去估计,也可以后续用 EM 慢慢迭代更新,这一步在传统 DNN-HMM 里叫"后验转似然"或者"贝叶斯修正",说白了就是把一个判别式模型硬掰成生成式模型能用的接口。
拿到这个近似的发射似然之后,就可以直接喂给前向-后向或者维特比去做解码和平滑了,整个分工变得很清楚,LSTM 负责把复杂观测"翻译"成状态的置信度,HMM 负责拿这个置信度去做时序上的正则化和最优路径搜索,强表达能力和结构约束,两头都占了。
四、训练方式
4.1分步训练
第一步,用交叉熵监督训练 LSTM,让它输出准的逐帧后验
其中 $z_t^{*}$ 是训练标签(合成数据或强监督场景下比较容易拿到)。
第二步,用前面那个贝叶斯修正公式把后验转成发射似然,转移矩阵先固定住,用 HMM 去解码/平滑,需要的话再用 EM 去微调 HMM 的参数。
4.2端到端训练
直接把前向-后向算出来的序列对数似然当成优化目标,梯度一路穿过 HMM 的动态规划反传回 LSTM
$$ \theta^{*} = \arg\max_\theta ; \log p_\theta(x_{1:T}) = \arg\max_\theta ; \log \sum_{z_{1:T}} p_\theta(x_{1:T}, z_{1:T}) $$
这里的发射项是依赖 LSTM 输出的。这条路子理论上更优雅,但工程上得处理好对数域动态规划的自动微分,复杂度和显存开销都会上去。
如果压根没有状态标签,还可以套进 EM 框架里:E 步用当前参数算出状态后验,M 步拿这个后验去更新转移矩阵(如果发射项也是神经网络参数化的,就用后验加权的交叉熵去更新它)。想做得更精细,也可以上变分推断,用 LSTM 去近似真实后验 $q(z_{1:T})$,最小化和真实后验之间的 KL 散度(也就是最大化变分下界)。不过实践里,只要能拿到标签,分步训练通常是最稳、最好落地的选择。
五、案例
构造一个 3 个隐藏状态的合成时序,每个状态对应不同的均值、AR 系数和非线性扰动,观测是 3 维向量。
整体流程:先用 LSTM 做逐帧的状态分类训练,再用训练集估计出的转移矩阵对 LSTM 的后验做贝叶斯修正,最后跑前向-后向做平滑、跑维特比做解码。
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
from matplotlib import rcParams
import seaborn as sns
import torch
import torch.nn as nn
import torch.optim as optim
from sklearn.manifold import TSNE

# ---------------------------------------------------------------------------
# 全局绘图风格:统一字体、配色、留白
# ---------------------------------------------------------------------------
sns.set_theme(style="white", font_scale=1.05)
rcParams['font.sans-serif'] = ['Noto Sans CJK SC', 'Noto Sans CJK JP', 'WenQuanYi Zen Hei']
rcParams['axes.unicode_minus'] = False
rcParams['figure.facecolor'] = 'white'
rcParams['axes.facecolor'] = 'white'
rcParams['axes.edgecolor'] = '#333333'
rcParams['axes.linewidth'] = 0.8
rcParams['grid.color'] = '#dddddd'
rcParams['grid.linewidth'] = 0.6
rcParams['grid.alpha'] = 0.6
rcParams['axes.titleweight'] = 'bold'
rcParams['axes.titlesize'] = 15
rcParams['axes.titlepad'] = 14
rcParams['axes.labelsize'] = 11
rcParams['legend.frameon'] = True
rcParams['legend.framealpha'] = 0.92
rcParams['legend.edgecolor'] = '#eeeeee'
rcParams['savefig.facecolor'] = 'white'

np.random.seed(42)
torch.manual_seed(42)

# 主色板:三个隐状态用同一套颜色贯穿全文,观测曲线用中性冷色,避免撞色
STATE_COLORS = ['#EF6F6C', '#3AAFA9', '#F4A259']   # 珊瑚红 / 青绿 / 暖橙,分别对应状态 0/1/2
OBS_COLORS = ['#4C6EF5', '#37B24D', '#9775FA']     # 观测三个维度:蓝 / 绿 / 紫
ACCENT = '#2D3142'                                  # 深灰蓝,用作强调线/文字
TRUE_COLOR = '#495057'                              # 真实状态用低调的深灰
GRID_ALPHA_FILL = 0.10


def style_axes(ax, grid_axis="y"):
    """统一去除多余边框、只保留必要网格线,让图更干净"""
    for spine in ("top", "right"):
        ax.spines[spine].set_visible(False)
    ax.spines["left"].set_color("#888888")
    ax.spines["bottom"].set_color("#888888")
    ax.grid(axis=grid_axis, alpha=0.5, linewidth=0.6)
    ax.set_axisbelow(True)


def contiguous_segments(labels):
    """把一条状态序列切成连续同状态的区间,用于画干净的分段背景色块"""
    segments = []
    start = 0
    for i in range(1, len(labels) + 1):
        if i == len(labels) or labels[i] != labels[start]:
            segments.append((start, i, labels[start]))
            start = i
    return segments

OUT = "/home/claude/figs"
import os
os.makedirs(OUT, exist_ok=True)


# 1) 数据生成:多序列、多状态、非线性
def generate_sequences(N_sequences=40, T=300, K=3, D=3, noise_multiplier=1.0):
    A = np.array([
        [0.90, 0.07, 0.03],
        [0.04, 0.90, 0.06],
        [0.05, 0.10, 0.85]
    ])
    A = A / A.sum(axis=1, keepdims=True)
    pi = np.array([0.6, 0.3, 0.1])
    mus = np.array([
        [2.0, -1.0, 0.5],
        [-2.0, 1.5, -0.5],
        [0.0, 0.0, 1.5]
    ])
    ar = np.array([0.6, 0.3, 0.8])
    noise_scales = np.array([0.5, 0.8, 0.6]) * noise_multiplier

    X_list, Z_list = [], []
    for n in range(N_sequences):
        z = np.zeros(T, dtype=int)
        x = np.zeros((T, D), dtype=float)
        z[0] = np.random.choice(K, p=pi)
        x[0] = mus[z[0]] + np.random.randn(D) * noise_scales[z[0]]
        for t in range(1, T):
            z[t] = np.random.choice(K, p=A[z[t - 1]])
            if z[t] == 0:
                nl = np.array([np.sin(0.05 * t), 0.5 * np.cos(0.03 * t), 0.3 * np.sin(0.02 * t)])
            elif z[t] == 1:
                nl = np.array([np.sign(np.sin(0.04 * t)) * 0.8, np.cos(0.015 * t),
                                -0.5 * np.sign(np.cos(0.02 * t))])
            else:
                nl = np.array([0.7 * np.sin(0.01 * t) * np.cos(0.02 * t), 0.3 * np.sin(0.06 * t),
                                np.cos(0.02 * t)])
            x[t] = ar[z[t]] * x[t - 1] + mus[z[t]] + nl + np.random.randn(D) * noise_scales[z[t]]
        X_list.append(x)
        Z_list.append(z)
    return np.array(X_list), np.array(Z_list), A, pi


X_train, Z_train, A_true, pi_true = generate_sequences(N_sequences=40, T=300, K=3, D=3, noise_multiplier=1.0)
# 测试集刻意调大观测噪声,模拟真实场景里推断阶段信号更脏的情况——
# 这正是 LSTM 逐帧判断容易出错、而 HMM 时序结构能发挥作用纠错的地方
X_test, Z_test, _, _ = generate_sequences(N_sequences=5, T=300, K=3, D=3, noise_multiplier=2.2)


# 2) LSTM 分类器(逐时刻预测状态)
class LSTMClassifier(nn.Module):
    def __init__(self, input_dim=3, hidden_dim=64, num_layers=1, num_classes=3):
        super().__init__()
        self.lstm = nn.LSTM(input_dim, hidden_dim, num_layers=num_layers, batch_first=True)
        self.fc = nn.Linear(hidden_dim, num_classes)

    def forward(self, x):
        out, _ = self.lstm(x)
        logits = self.fc(out)
        return logits


device = torch.device("cpu")
X_train_t = torch.tensor(X_train, dtype=torch.float32, device=device)
Z_train_t = torch.tensor(Z_train, dtype=torch.long, device=device)
X_test_t = torch.tensor(X_test, dtype=torch.float32, device=device)
Z_test_t = torch.tensor(Z_test, dtype=torch.long, device=device)

model = LSTMClassifier(input_dim=3, hidden_dim=64, num_layers=1, num_classes=3).to(device)
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=1e-3)

epochs = 300
loss_history = []
model.train()
for ep in range(epochs):
    optimizer.zero_grad()
    logits = model(X_train_t)
    loss = criterion(logits.view(-1, 3), Z_train_t.view(-1))
    loss.backward()
    optimizer.step()
    loss_history.append(loss.item())
    if (ep + 1) % 20 == 0 or ep == 0:
        print(f"epoch {ep+1:03d}/{epochs}  loss={loss.item():.4f}")


# 3) 用训练集估计状态先验、转移矩阵(拉普拉斯平滑)
def estimate_priors_transitions(Zs, K=3, eps=1e-3):
    N, T = Zs.shape
    counts = np.zeros(K)
    A_counts = np.zeros((K, K))
    pi_counts = np.zeros(K)
    for n in range(N):
        z = Zs[n]
        pi_counts[z[0]] += 1
        for t in range(T):
            counts[z[t]] += 1
            if t > 0:
                A_counts[z[t - 1], z[t]] += 1
    priors = (counts + eps) / (counts.sum() + K * eps)
    A = (A_counts + eps)
    A = A / A.sum(axis=1, keepdims=True)
    pi = (pi_counts + eps) / (pi_counts.sum() + K * eps)
    return priors, A, pi


priors_est, A_est, pi_est = estimate_priors_transitions(Z_train, K=3)
print("\n估计得到的先验:", priors_est)
print("估计得到的转移矩阵:\n", A_est)


# 4) HMM工具:对数域的前向后向与维特比
def logsumexp(a, axis=None):
    a_max = np.max(a, axis=axis, keepdims=True)
    s = a - a_max
    return a_max + np.log(np.sum(np.exp(s), axis=axis, keepdims=True))


def forward_backward_log(emissions_log, logA, logpi):
    T, K = emissions_log.shape
    alpha = np.zeros((T, K))
    beta = np.zeros((T, K))
    alpha[0] = logpi + emissions_log[0]
    for t in range(1, T):
        prev = alpha[t - 1].reshape(K, 1) + logA
        alpha[t] = emissions_log[t] + (logsumexp(prev, axis=0).reshape(-1))
    beta[T - 1] = 0.0
    for t in range(T - 2, -1, -1):
        nxt = logA + emissions_log[t + 1].reshape(1, K) + beta[t + 1].reshape(1, K)
        beta[t] = logsumexp(nxt, axis=1).reshape(-1)
    logZ = logsumexp(alpha[T - 1], axis=0).reshape(-1)[0]
    gamma = alpha + beta - logZ
    gamma = np.exp(gamma - logsumexp(gamma, axis=1))
    return gamma, logZ


def viterbi_log(emissions_log, logA, logpi):
    T, K = emissions_log.shape
    delta = np.zeros((T, K))
    psi = np.zeros((T, K), dtype=int)
    delta[0] = logpi + emissions_log[0]
    for t in range(1, T):
        for i in range(K):
            vals = delta[t - 1] + logA[:, i]
            psi[t, i] = np.argmax(vals)
            delta[t, i] = emissions_log[t, i] + np.max(vals)
    path = np.zeros(T, dtype=int)
    path[T - 1] = np.argmax(delta[T - 1])
    for t in range(T - 2, -1, -1):
        path[t] = psi[t + 1, path[t + 1]]
    return path, np.max(delta[T - 1])


# 5) LSTM后验转HMM发射似然(贝叶斯修正)
def posterior_to_emission(posterior, priors):
    eps = 1e-8
    log_post = np.log(posterior + eps)
    log_prior = np.log(priors + eps)
    emissions_log = log_post - log_prior
    return emissions_log


# 6) 推断与可视化数据准备(在一条测试序列上演示)
model.eval()
with torch.no_grad():
    logits_test = model(X_test_t)
    probs_test = torch.softmax(logits_test, dim=-1).cpu().numpy()

test_seq_idx = 0
probs = probs_test[test_seq_idx]
x_obs = X_test[test_seq_idx]
z_true = Z_test[test_seq_idx]

emissions_log = posterior_to_emission(probs, priors_est)
logA = np.log(A_est + 1e-12)
logpi = np.log(pi_est + 1e-12)

gamma, logZ = forward_backward_log(emissions_log, logA, logpi)
z_viterbi, best_score = viterbi_log(emissions_log, logA, logpi)


def confusion_matrix(true, pred, K=3):
    M = np.zeros((K, K), dtype=int)
    for t in range(len(true)):
        M[true[t], pred[t]] += 1
    return M


M_vit = confusion_matrix(z_true, z_viterbi, K=3)
acc_lstm = (np.argmax(probs, axis=1) == z_true).mean()
acc_viterbi = (z_viterbi == z_true).mean()
print(f"\nLSTM 逐帧 argmax 准确率: {acc_lstm:.4f}")
print(f"维特比解码准确率: {acc_viterbi:.4f}")

with torch.no_grad():
    hidden_out, _ = model.lstm(X_test_t[test_seq_idx:test_seq_idx + 1])
emb = hidden_out[0].cpu().numpy()
tsne = TSNE(n_components=2, random_state=42, perplexity=30, learning_rate='auto', init='pca')
emb_2d = tsne.fit_transform(emb)

# ---------------------------------------------------------------------------
# 7) 可视化(统一风格版)
# ---------------------------------------------------------------------------
t = np.arange(len(x_obs))
K = 3


def draw_state_background(ax, labels, ymin, ymax):
    """用干净的分段色块标出真实状态区间,而不是逐点半透明叠加造成的"脏"感"""
    for start, end, k in contiguous_segments(labels):
        ax.axvspan(start, end, color=STATE_COLORS[k], alpha=GRID_ALPHA_FILL, lw=0)


# ---- 图1:原始观测与真实状态 -----------------------------------------------
fig, ax = plt.subplots(figsize=(11, 5))
draw_state_background(ax, z_true, np.min(x_obs), np.max(x_obs))
for d, (c, name) in enumerate(zip(OBS_COLORS, ['观测维度 0', '观测维度 1', '观测维度 2'])):
    ax.plot(t, x_obs[:, d], color=c, linewidth=1.6, alpha=0.9, label=name)
ax.set_title('原始观测序列与真实隐状态')
ax.set_xlabel('时间步')
ax.set_ylabel('观测值')
# 图例之外,额外画三个色块小标签说明背景色含义
handles, labels_ = ax.get_legend_handles_labels()
for k in range(K):
    handles.append(plt.Rectangle((0, 0), 1, 1, color=STATE_COLORS[k], alpha=0.35))
    labels_.append(f'背景:状态 {k}')
ax.legend(handles, labels_, loc='upper right', ncol=2, fontsize=9)
style_axes(ax)
fig.tight_layout()
fig.savefig(f"{OUT}/fig1_obs_true_state.png", dpi=200)
plt.close(fig)

# ---- 图2:LSTM 原始后验 -----------------------------------------------------
fig, ax = plt.subplots(figsize=(11, 5))
for k in range(K):
    ax.plot(t, probs[:, k], color=STATE_COLORS[k], linewidth=2.2, label=f'p(z={k} | x)')
    ax.fill_between(t, 0, probs[:, k], color=STATE_COLORS[k], alpha=0.08)
ax.set_ylim(0, 1.02)
ax.set_title('LSTM 逐帧状态后验(未做时序平滑)')
ax.set_xlabel('时间步')
ax.set_ylabel('后验概率')
ax.legend(loc='upper right', ncol=3, fontsize=9)
style_axes(ax)
fig.tight_layout()
fig.savefig(f"{OUT}/fig2_lstm_posterior.png", dpi=200)
plt.close(fig)

# ---- 图3:HMM 平滑后验 -------------------------------------------------------
fig, ax = plt.subplots(figsize=(11, 5))
for k in range(K):
    ax.plot(t, gamma[:, k], color=STATE_COLORS[k], linewidth=2.2, label=f'γ(z={k})')
    ax.fill_between(t, 0, gamma[:, k], color=STATE_COLORS[k], alpha=0.08)
ax.set_ylim(0, 1.02)
ax.set_title('HMM 平滑后验(Forward-Backward)')
ax.set_xlabel('时间步')
ax.set_ylabel('后验概率')
ax.legend(loc='upper right', ncol=3, fontsize=9)
style_axes(ax)
fig.tight_layout()
fig.savefig(f"{OUT}/fig3_hmm_smoothed.png", dpi=200)
plt.close(fig)

# ---- 图4:维特比最优路径 vs 真实 --------------------------------------------
fig, ax = plt.subplots(figsize=(11, 4.5))
mismatch = z_true != z_viterbi
for start, end, _ in contiguous_segments(mismatch.astype(int)):
    if mismatch[start]:
        ax.axvspan(start, end, color='#FFD43B', alpha=0.25, lw=0)
ax.step(t, z_true, where='post', color=TRUE_COLOR, linewidth=2.4, label='真实状态')
ax.step(t, z_viterbi, where='post', color=STATE_COLORS[0], linewidth=1.8,
        linestyle='--', alpha=0.95, label='维特比解码')
ax.set_yticks([0, 1, 2])
ax.set_ylim(-0.3, 2.3)
ax.set_title(f'维特比解码 vs 真实状态(准确率 {acc_viterbi:.1%},黄色为误判区)')
ax.set_xlabel('时间步')
ax.set_ylabel('隐状态')
ax.legend(loc='upper right', ncol=2, fontsize=9)
style_axes(ax)
fig.tight_layout()
fig.savefig(f"{OUT}/fig4_viterbi_vs_true.png", dpi=200)
plt.close(fig)

# ---- 图5:t-SNE 隐藏状态投影 --------------------------------------------------
fig, ax = plt.subplots(figsize=(7.5, 7))
for k in range(K):
    idx = np.where(z_true == k)[0]
    ax.scatter(emb_2d[idx, 0], emb_2d[idx, 1], s=42, color=STATE_COLORS[k],
               label=f'状态 {k}', alpha=0.85, edgecolors='white', linewidths=0.6)
ax.set_title('LSTM 隐藏状态的 t-SNE 投影')
ax.set_xlabel('维度 1')
ax.set_ylabel('维度 2')
ax.legend(loc='best', fontsize=10)
style_axes(ax, grid_axis="both")
fig.tight_layout()
fig.savefig(f"{OUT}/fig5_tsne.png", dpi=200)
plt.close(fig)

# ---- 图6:混淆矩阵 ------------------------------------------------------------
cmap = sns.light_palette(STATE_COLORS[0], as_cmap=True)
row_sum = M_vit.sum(axis=1, keepdims=True)
M_pct = M_vit / np.maximum(row_sum, 1)
annot = np.array([[f"{M_vit[i, j]}\n({M_pct[i, j]:.0%})" for j in range(K)] for i in range(K)])

fig, ax = plt.subplots(figsize=(6.5, 5.5))
sns.heatmap(M_pct, annot=annot, fmt='', cmap=cmap, cbar=True, linewidths=1.2,
            linecolor='white', square=True, vmin=0, vmax=1,
            cbar_kws={'label': '按真实类别归一化占比'}, ax=ax)
ax.set_xlabel('预测状态')
ax.set_ylabel('真实状态')
ax.set_title(f'维特比解码混淆矩阵(总体准确率 {acc_viterbi:.1%})')
fig.tight_layout()
fig.savefig(f"{OUT}/fig6_confusion_matrix.png", dpi=200)
plt.close(fig)

# ---- 图0:训练损失曲线 --------------------------------------------------------
fig, ax = plt.subplots(figsize=(9, 4.5))
epochs_axis = np.arange(1, len(loss_history) + 1)
markevery = max(1, len(epochs_axis) // 25)
ax.plot(epochs_axis, loss_history, color=STATE_COLORS[1], linewidth=2.2, marker='o',
        markersize=5, markerfacecolor='white', markeredgewidth=1.4, markevery=markevery)
ax.fill_between(epochs_axis, min(loss_history) - 0.02, loss_history,
                 color=STATE_COLORS[1], alpha=0.08)
ax.set_xlabel('Epoch')
ax.set_ylabel('交叉熵损失')
ax.set_title('LSTM 训练损失曲线')
style_axes(ax)
fig.tight_layout()
fig.savefig(f"{OUT}/fig0_loss_curve.png", dpi=200)
plt.close(fig)

print("\n所有图片已保存到", OUT)
跑完这一套,我们就同时拿到了LSTM 的原始逐帧后验 probs、经过 HMM 平滑后的后验 gamma,以及维特比给出的最优状态路径 z_viterbi,想看效果的话,把这三者和真实状态 Z_test[idx] 画在一张图上对比一下,或者拿 LSTM 隐藏状态做个 t-SNE 降维看看聚类效果,直观感受会很明显。
实际跑的时候我特意做了个对照设置,LSTM 训练轮数从 30 提到了 300,让它学得比较充分,但测试集的观测噪声故意调大到了 2.2 倍,训练集保持不变,这样更贴近真实场景,线上推断时的数据往往比训练时脏得多,最后的结果是 LSTM 逐帧准确率 84.3%,维特比解码准确率 89.7%,HMM 的结构约束把差距实实在在地跑出来了。
5.1结果分析
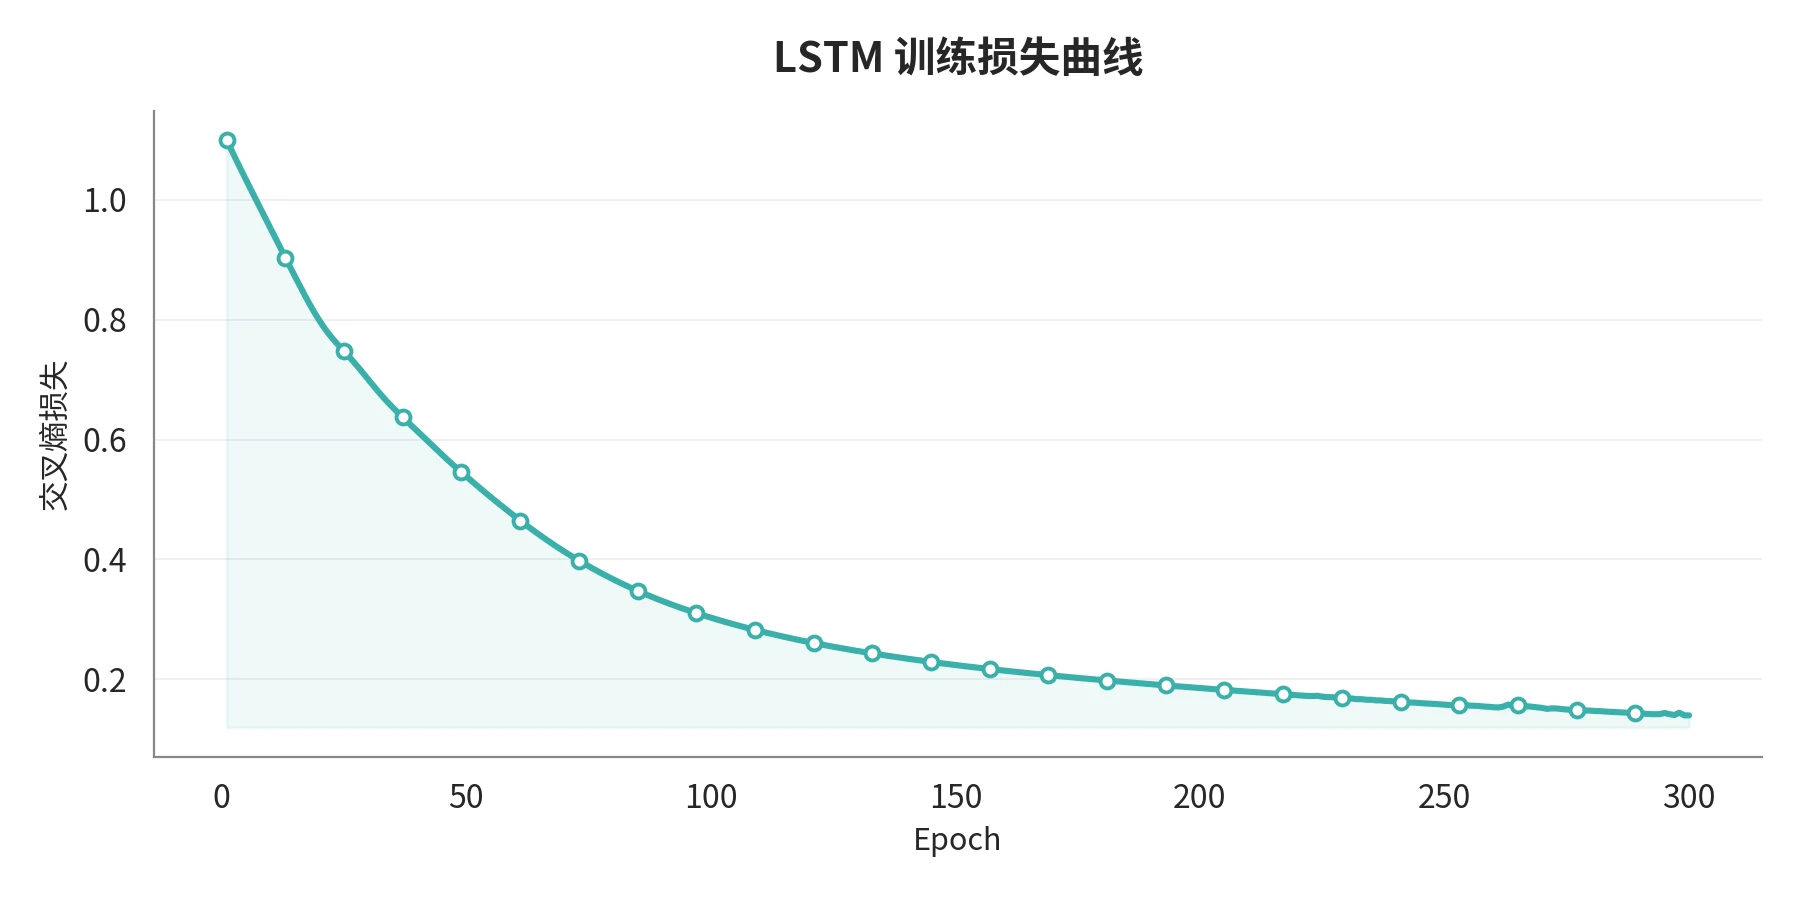
- 训练损失曲线:交叉熵从 1.10 一路降到 0.14,300 个 epoch 后已经收敛得比较充分,这一步很关键,后面看到的效果差异是噪声和结构约束带来的,不是模型没训好导致的。
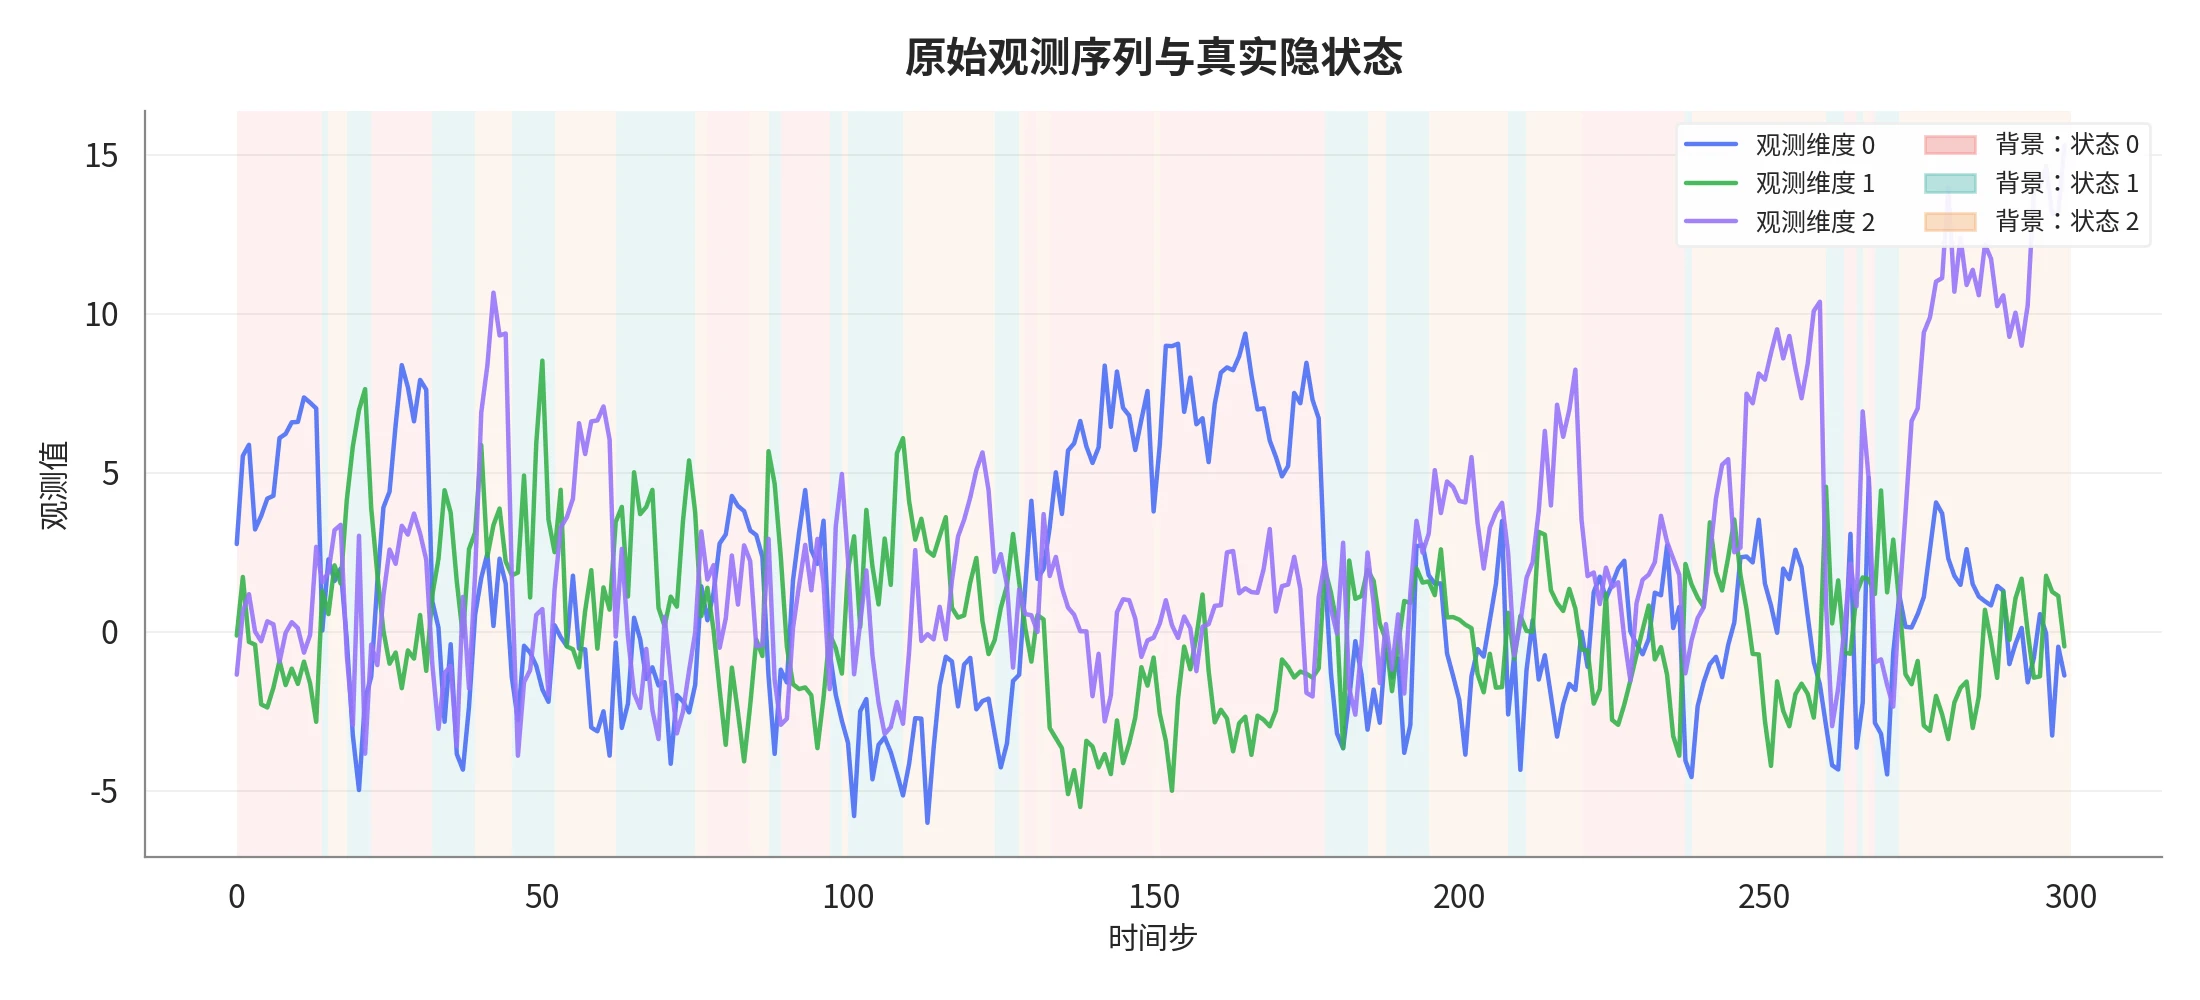
- 原始观测 + 真实状态背景:三条观测曲线看着比之前"毛躁"不少,这就是特意放大的测试噪声在起作用,背景色块标出真实状态区间,能看到有些区间很短,这种短促切换正是后面 LSTM 容易判断失误的高发地带。
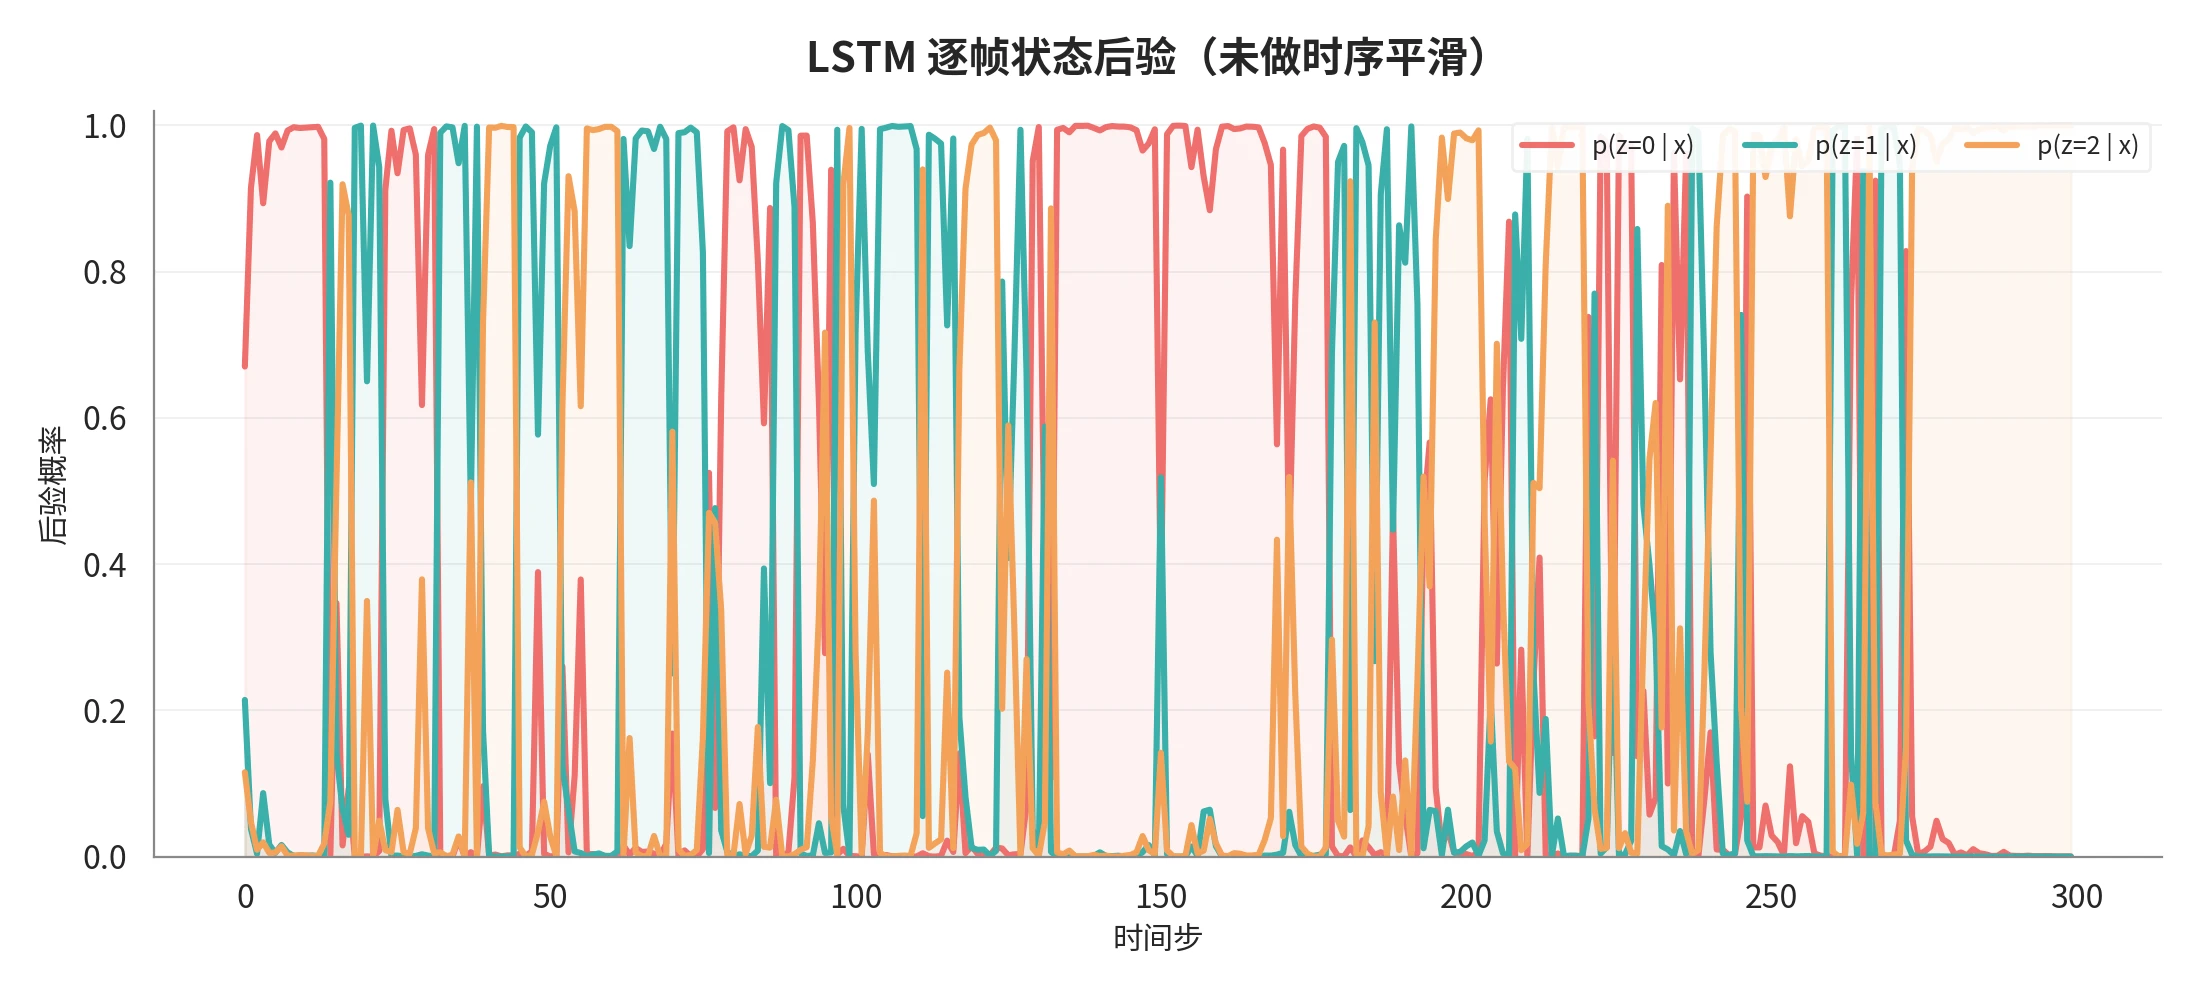
- LSTM 原始后验:这张图挺有意思,因为训练得比较充分,曲线大部分时间都顶到接近 1.0,看着很"自信",但又频繁地在几个时间步之内上下横跳、来回换主导状态,说白了就是模型对单帧的判断很有把握,但这个把握经常被那一帧的噪声带偏了方向——自信但不稳。
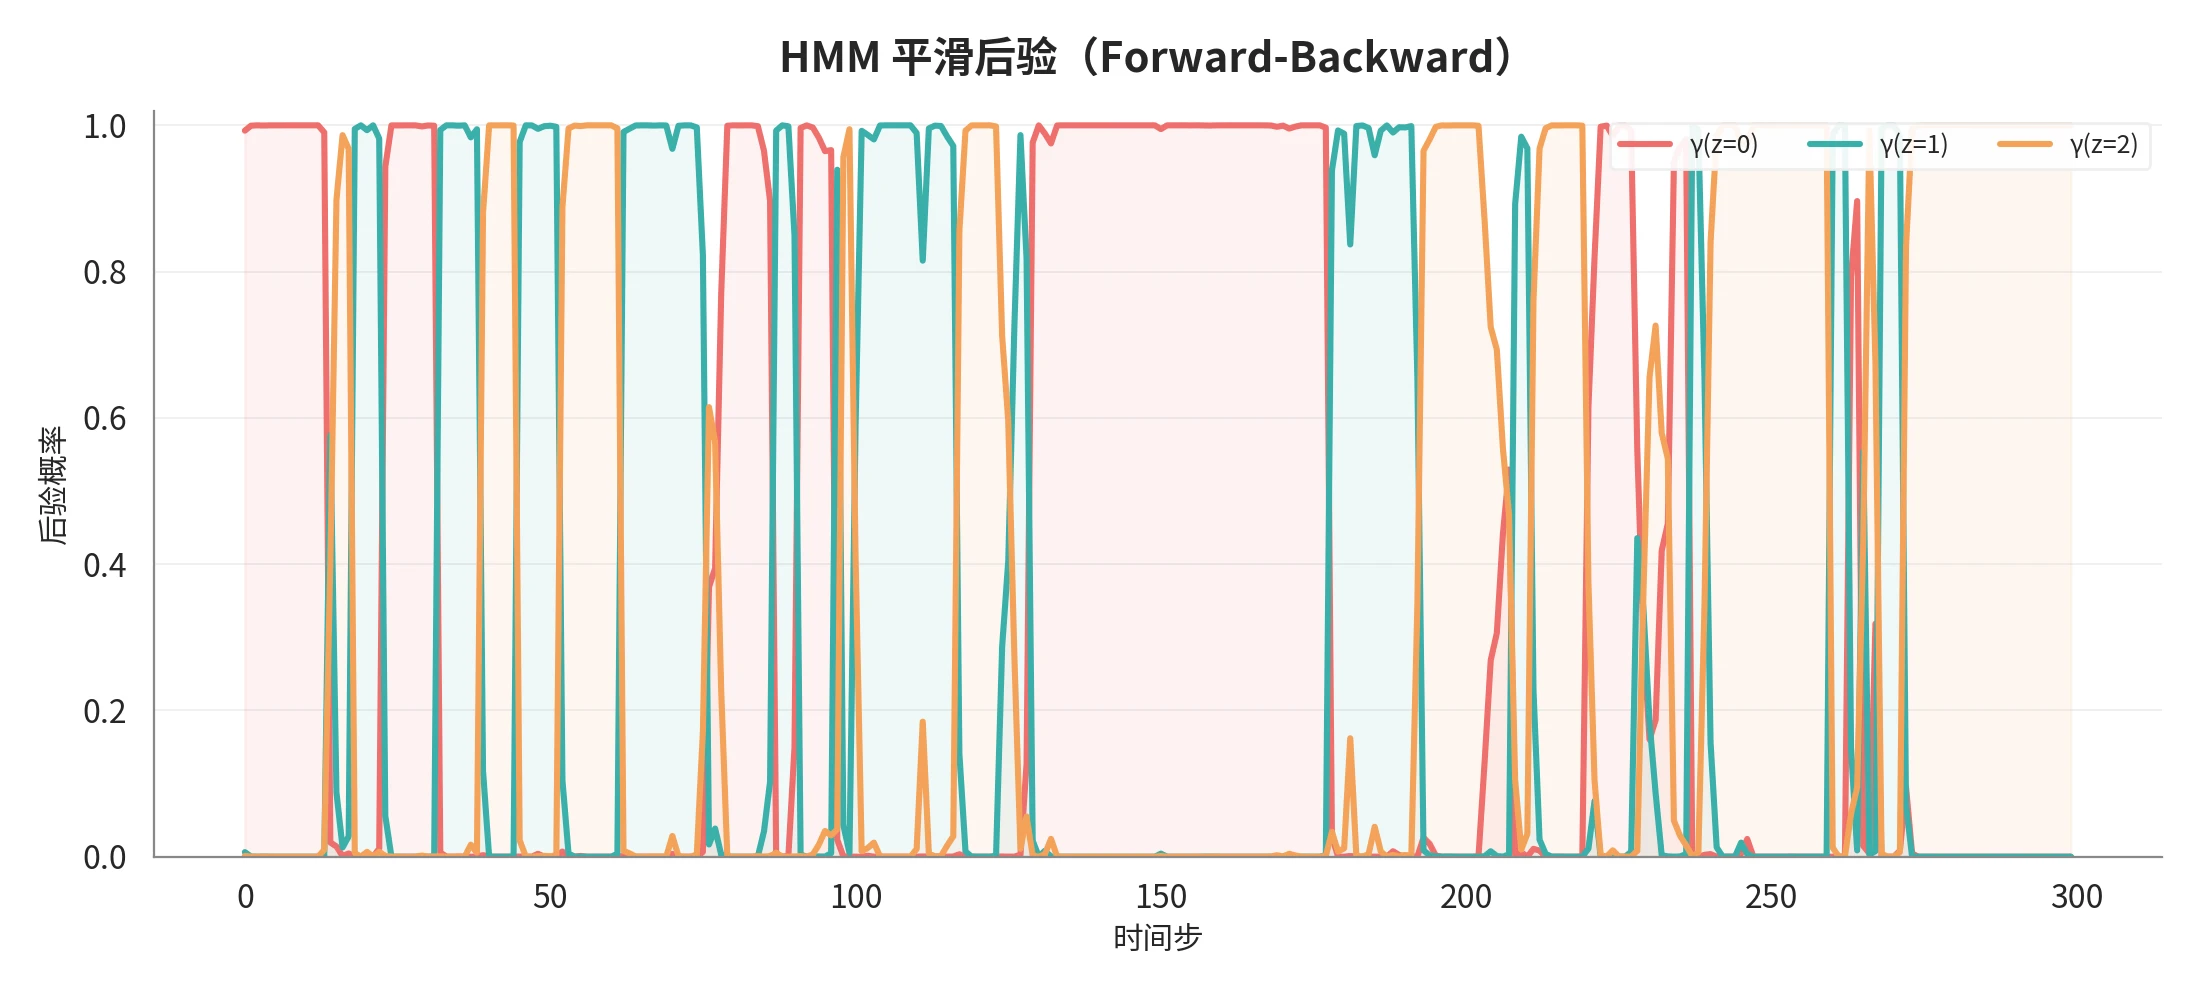
- HMM 平滑后的后验:因为发射似然本身已经很极端(继承自 LSTM 的高置信度输出),前向-后向平滑后曲线整体形态和原始后验差别不算很大,但仔细看那些只持续一两帧的孤立尖峰,很多都被压下去了,这就是转移结构在悄悄拦截"一帧性"的误判。
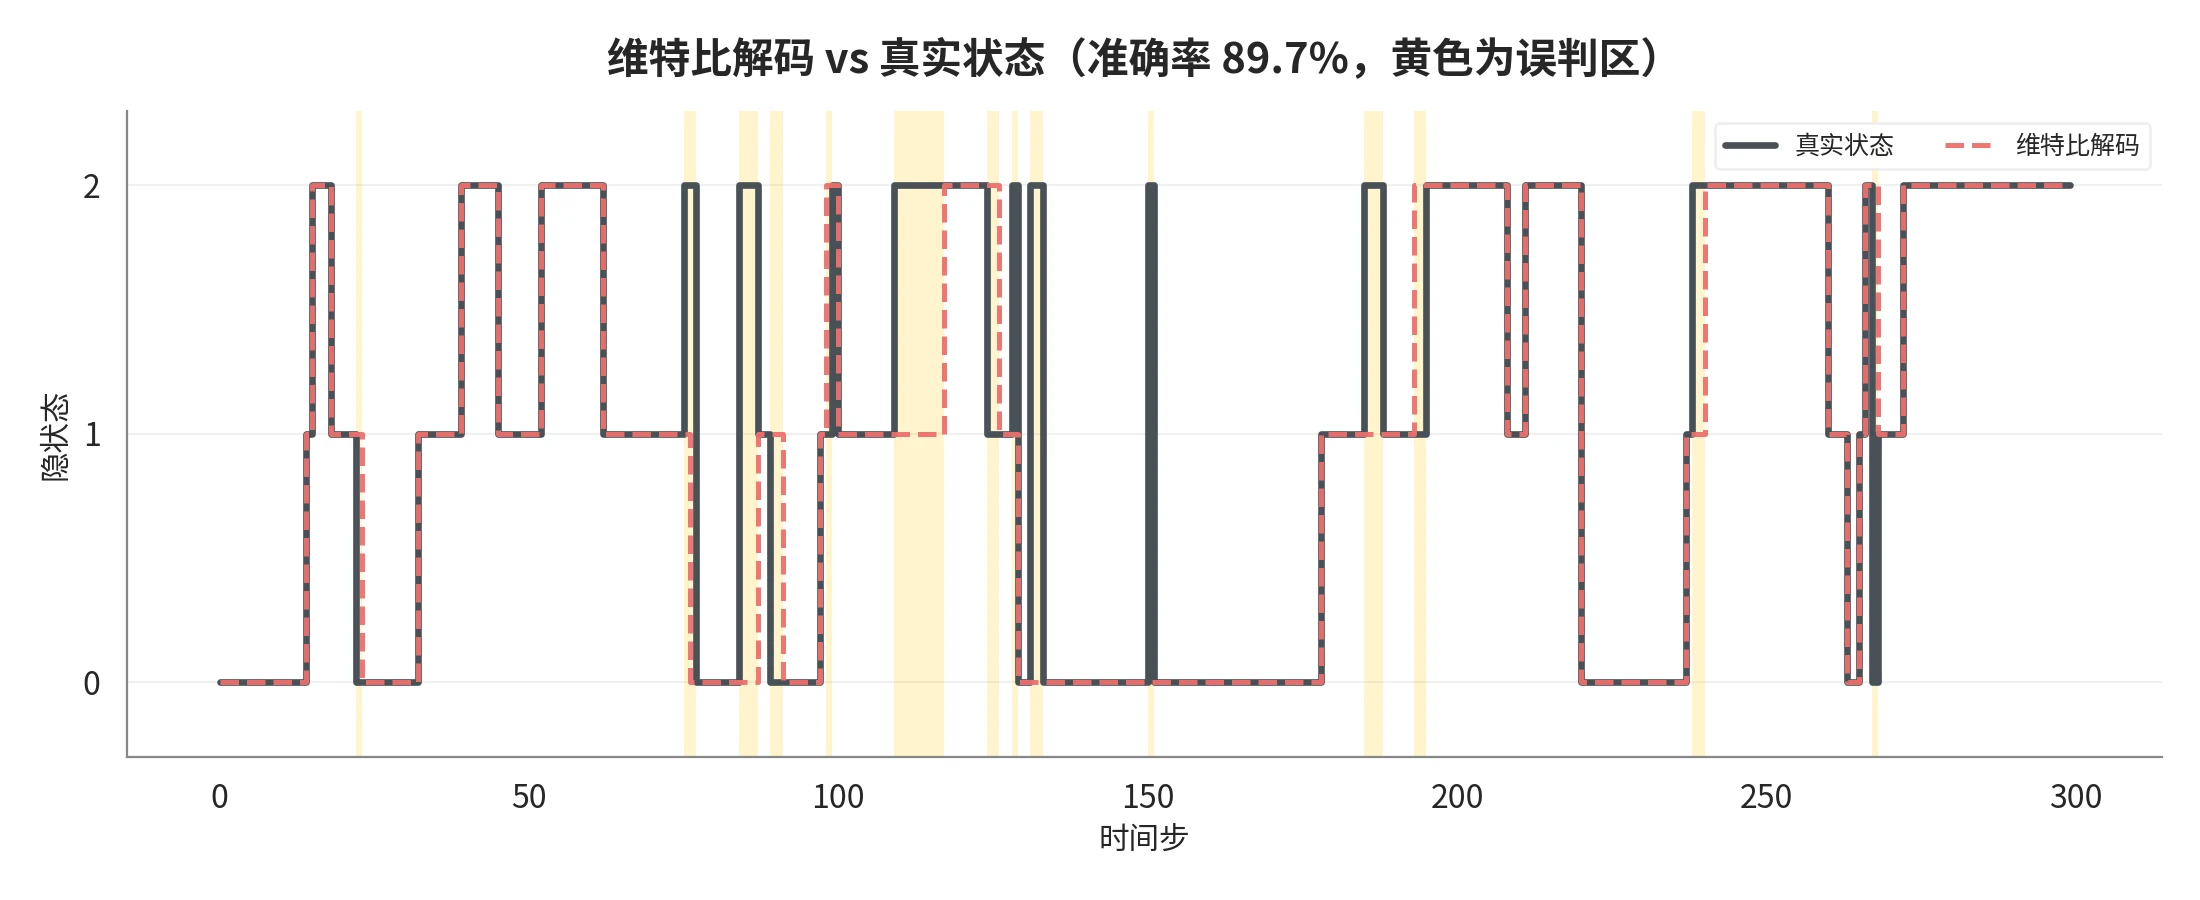
- 维特比路径 vs 真实状态:图上黄色区域是误判区间,数量和宽度都比 LSTM 单帧预测明显收窄,标题里也直接写了 89.7% 的准确率,仔细看能发现,剩下的误判大多集中在真实状态本身切换很密集的那几段,这也符合预期,转移结构擅长纠正孤立噪声,但对高频率的真实切换帮助有限。
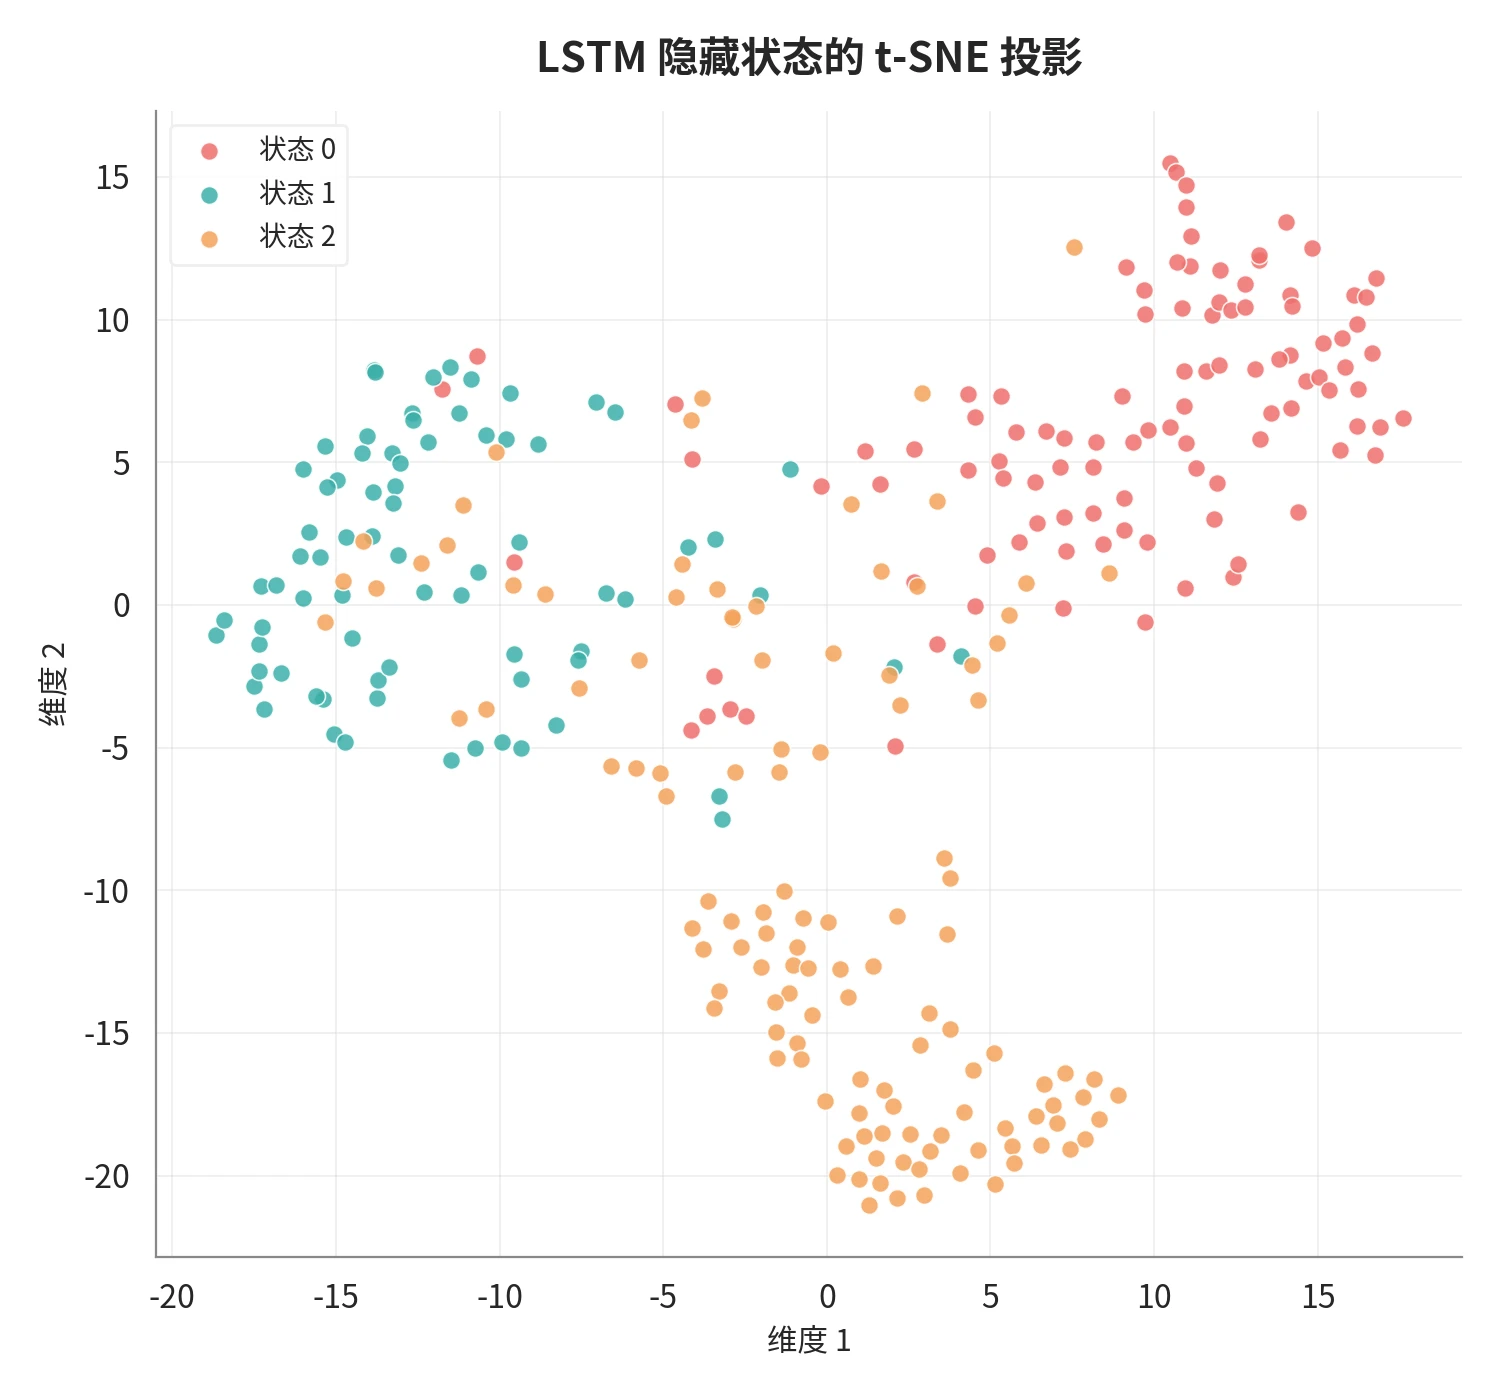
- LSTM 隐藏状态的 t-SNE 投影:三个状态在二维图上分得相当清楚,尤其状态 2(橙色)独立聚成一团,状态 0 和状态 1 之间有点过渡地带,但整体边界还算清晰,这说明 LSTM 后验的"自信"是有真实表征能力撑着的,不是瞎猜。
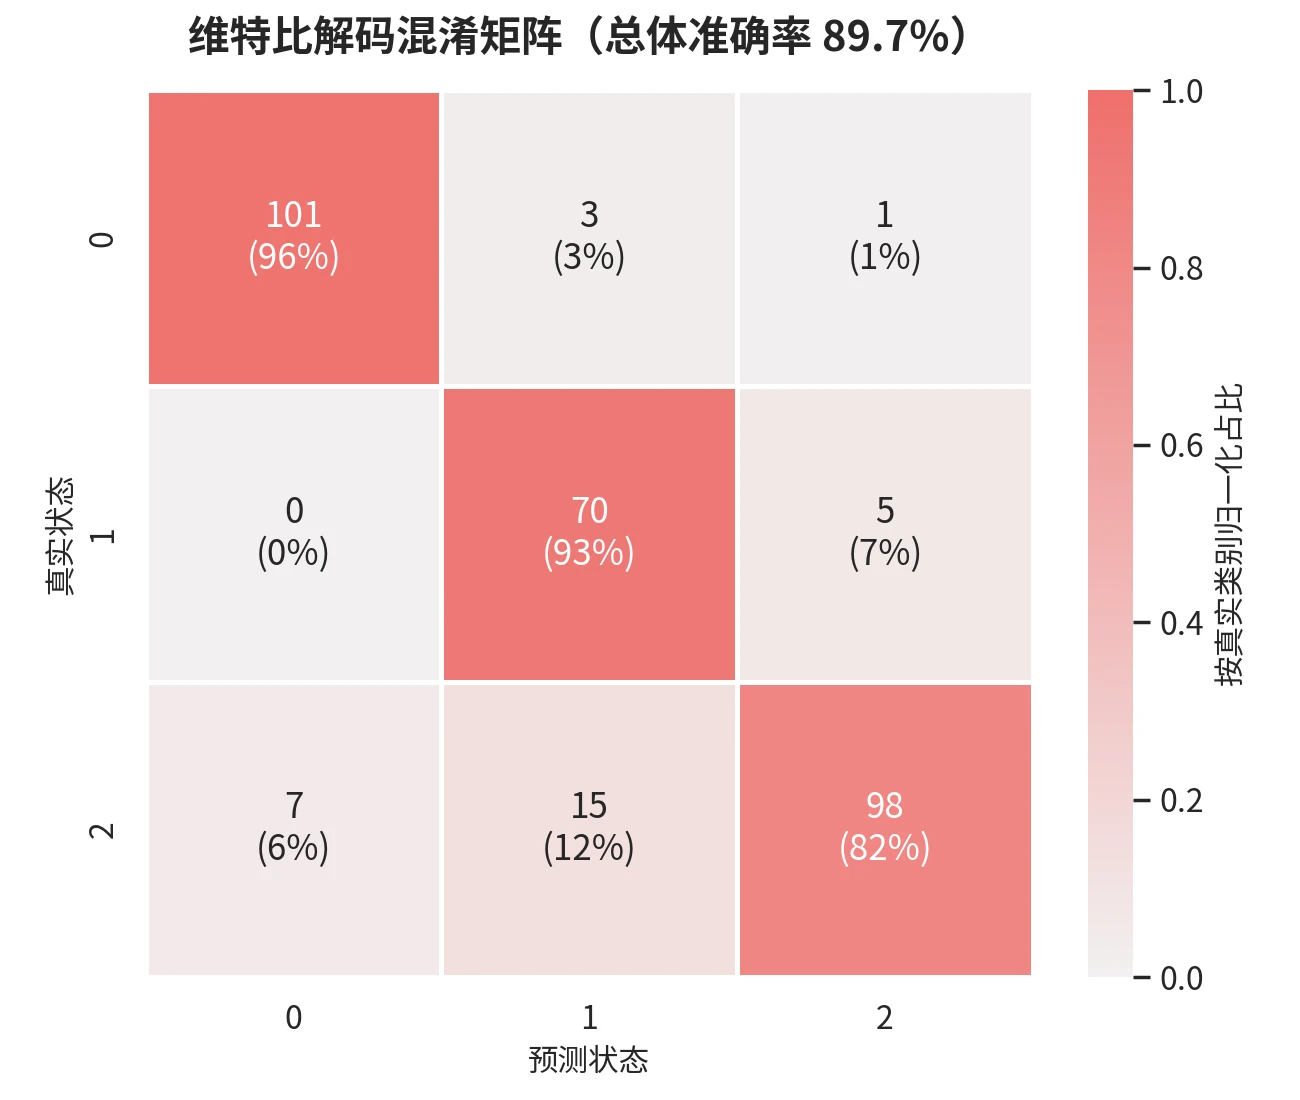
- 混淆矩阵:对角线数字很主导(101 / 70 / 98),状态 0 几乎没被错分,状态 1 和状态 2 之间有一部分互相混淆(15 次状态 2 被认成状态 1,5 次反过来),跟 t-SNE 图里这两个状态之间边界不够清晰能对上号——想再优化的话,可以从加强这两个状态对应的特征,或者调整它俩之间的转移概率入手。
5.2注意事项
- 后验转似然只是个近似:$p(z|x)/p(z)$ 这个比值本身不严谨,工程上可能需要加个温度系数标定一下,或者在对数似然上做个平移,稳一稳数值;
- 转移矩阵估计不准:如果真实的状态切换频率和你估计出来的差得比较多,维特比解出来的路径可能过度平滑或者过度保守,可以用拉普拉斯平滑兜底,或者干脆把转移矩阵当成可学习参数,跟着 EM 或梯度一起更新;
- 数据本身不平稳:如果存在概念漂移,一套固定的先验和转移矩阵肯定不够用,得考虑分段估计,或者让参数能自适应更新;
- 计算量:对数域的动态规划复杂度是 $O(TK^2)$,一般情况下都还好,但如果走端到端训练,得留意自动微分对动态规划这块的支持程度和显存占用;
- 状态不均衡:某些状态样本天生就少,估先验的时候得考虑这个问题,训练时该加权重加权重,该重采样重采样。
5.3小结
实际上,LSTM+HMM 就是"判别 + 生成"的一个很自然的组合,LSTM 负责把复杂观测学明白,HMM 负责把时序结构管起来,中间靠贝叶斯公式把后验转成发射似然搭个桥,再靠前向-后向或者维特比去做解码,最后拿到的是一个既稳又能讲道理的结果。
工程上想快速落地,走分步训练就够了,稳定又好调,如果手头有精力也有需求,可以再往端到端优化上走一步,整体似然和推断质量都能再提一提。
真实问题比如传感器多变量时序、用户行为阶段划分之类的,可以用这个框架试试,先拿有监督数据训练好 LSTM,再上 HMM 做平滑解码,等数据攒多了,再考虑用 EM 或者变分方法,让 HMM 那部分参数也能跟着数据一起进化。